
2026. 10. 28. 18:58ㆍComputer Science/DataBase
SQL 언어는 크게 세가지로 나눌 수 있다.
- Data-definition language (DDL) : Schema, Relation등에 대해 관리한다.
- Data-manipulation language (DML) : select, insert, delete from....
- Data-control lagnuage (DCL) : save point, rollback, commit.....
그리고 그중에서 정말 죽어라 줄창 쓸 DML 분법에 대해서 좀 알아보도록 하자.
Queries on Multiple Relations
select name
from friends
where dept_name = 'medical' and salary > 70000;
Select-From-Where은 단일 릴레이션에 대한 쿼리에서는 사실 죽어라 당연한 소리에 가깝다. 다만 여러개의 Relations에 대해서는 아래와 같이 생각하면 좋다.
- select 절은 쿼리의 결과로 나오고 싶은 attribute를 선택한다. 참고로 중복 없이 하고 싶으면 DISTINCT를 붙일 것.
- from 절은 쿼리에서 사용할 relation에 접근할 때 사용된다. 다만 여러개의 relation을 불러올 경우에는 그것들을 Cartesian Product 한 것들을 불러온다.
- where 절은 from절에서 불러온 relation들 중 특정 표현식에 맞는 놈들을 포함시킨다. Multuple Relation에 대해 from을 갈겼으면 거기서 나온 Cartesian Product에 대해서 조건 비교를 돌린다.
쨋든 Multiple Relation에 대한 from은 Cartesian Product(모든 경우의 수를 표기한 것)이고, 따라서 경우에 따라서 속성의 이름값이 겹칠 수 있다. 이럴 경우에는 A.attribute/B.attribute 와 같이 표기하거나 아예 select 단에서 Alias(별칭)을 붙이는 편이다.
select T.name, S.course_id
from instructor as T, teaches as S
where T.ID = S.ID;
물론 Alias는 이런 식으로 table에 대한 별칭으로 지정하는데 사용될 수 도 있다. 근데 왜 별칭을 지정 하기도 전에 select에서 튀어 나왔는가? 조금 의아할 수도 있다.
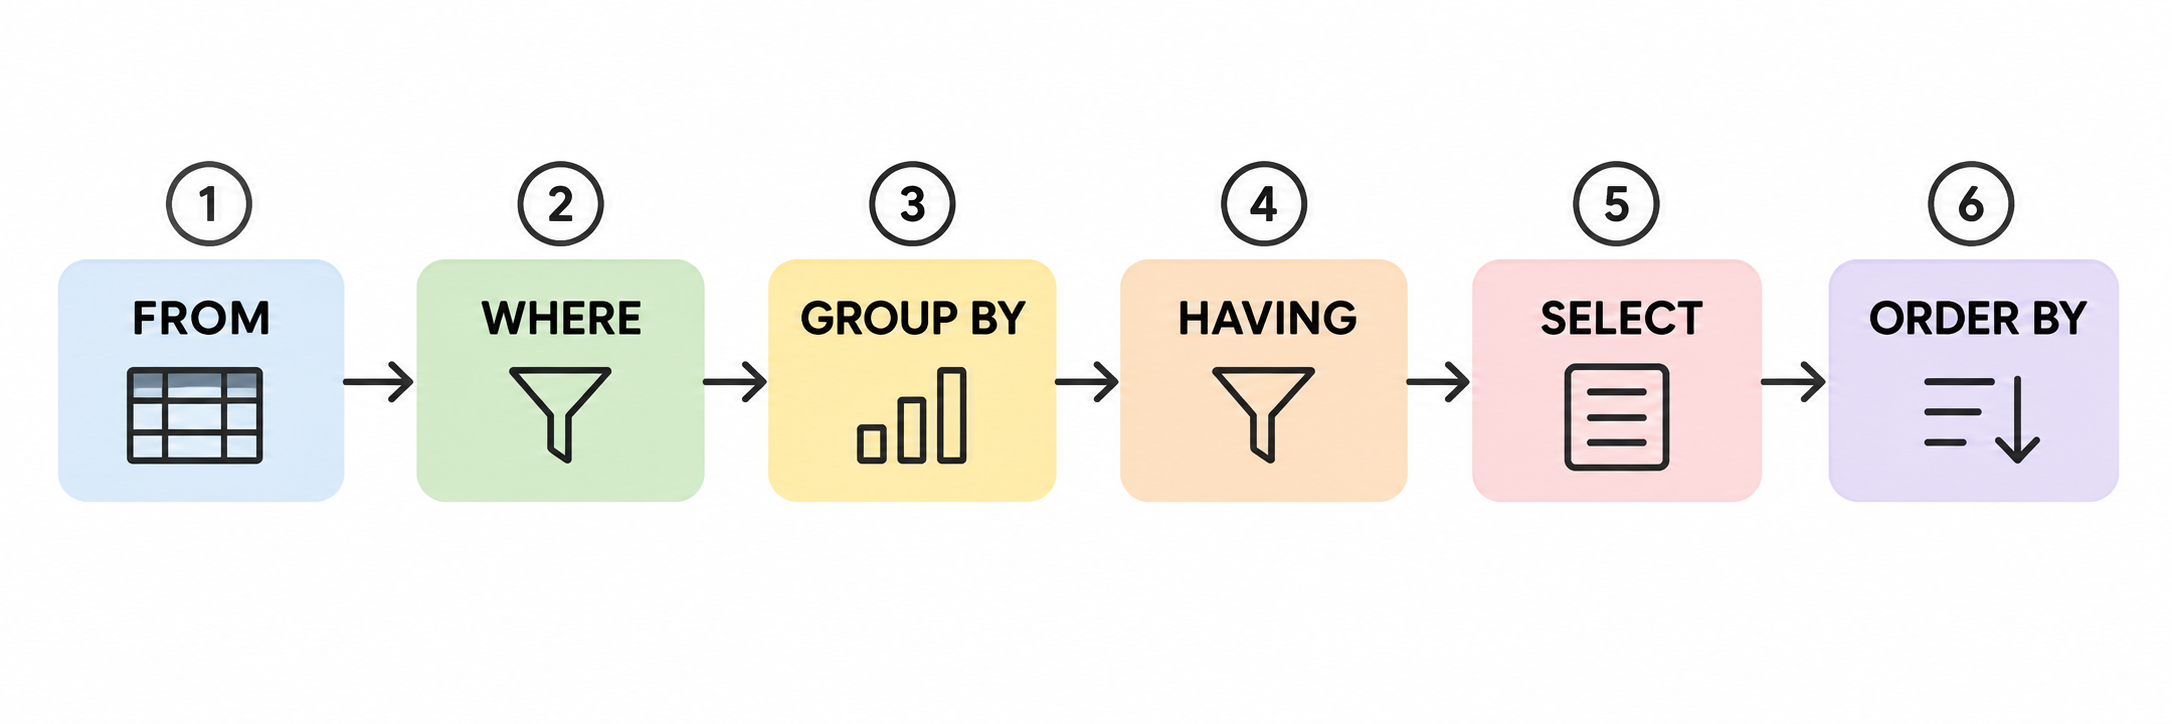
Aggregate Functions
집계 함수는 여러개의 값을 받아서 단일 값으로 퉤 하고 뱉어내는 함수라고 생각하면 된다. 그리고 여기에 들어가는 함수로는 avg, min, max, sum, count가 존재한다. (참고로 count는 tuple의 개수를 세는 함수다.)
select avg(salary) as avg_salary
from instructor
where dept_name = 'Medical';
근데, 문제는 뭐냐면, 튜플들의 단일 모임이 아니라 여러 모임에 대해서 데이터를 쭉쭉 뽑아내고 싶을 때가 있을 것 아닌가? 예를 들어서, 특정 부서마다 평균 연봉이 어떻게 되는지를 말이다. 쨋든 이럴 때는 뭐 속성을 하나 지정 하던가 해서 tuple들을 group으로 모아야 할 필요가 있는데, 이럴 때 사용되는게 바로 group by 절이다.
| id | dept | salary |
| 001 | qa | 100 |
| 002 | qa | 300 |
| 004 | hr | 200 |
| 005 | hr | 400 |
| 006 | dev | 600 |
| 007 | dev | 900 |
| 008 | med | 1500 |
| 009 | med | 2000 |
여기에 대해서 group by를 dept로 해주고, select dept, avg(salary) as avg_sal를 갈겨주면...
| dept | avg_sal |
| qa | 200 |
| hr | 300 |
| dev | 750 |
| med | 1750 |
이렇게 나올 것이다. 다만 저렇게 group by를 해서 나온 결과에 대해서 조건부 필터링을 걸고 싶을 때가 있을텐데, 그럴 때에는 having절을 사용해 주면 된다. having절 자체에도 집계 함수를 사용할 수 있긴 하지만, 반드시 group들이 형성 된 뒤에 사용해 주도록 해야한다.
Nested Subqueries
SQL은 서브쿼리를 네스팅 칠수 있게 해준다. 이때 서브쿼리란 select-from-where로 이루어 졌으면서, 동시에 다른 쿼리 안에 짱박혀 있는 쿼리를 의미한다. (스칼라로 튀어나오면 스칼라 서브쿼리라 함) 대표적인 용례를 SQL문을 직접 보면서 한번 보자.
select distinct course_id
from section
where semester = 'Fall' and year = 2017 and
course_id not in (select course_id from section where semester = 'Spring' and year=2018);
18년도 봄에 열리지 않은 17년도 가을 학기의 강의id를 찾는 쿼리다. 저걸 서브쿼리를 안치고 했으면 boolean opearion 때리느라 살짝 머리가 아팠을 수 도 있다.
select name
from instructor
where salary > some (select salary from instructor where dept_name = 'Biology');
생물학 가르치는 강사들 중에서 "적어도 이사람들 중 하나보다는" 봉급이 큰 강사를 찾는 쿼리다. 다만 some 뒤에 뭐가 오는 게 좀 익숙하지 않을 수 있는데, 대충 "~er than at least one"이라고 생각해 주면 된다. 다만 만약에 "~er than all"을 원한다면 >all과 같이 작성해 주어야 한다.
참고로, from절에도 Nested Subqurey를 갈길 수 있다. 왜냐하면 select-from-where의 결과가 릴레이션을 결과로 뱉어낼 수 있기 때문이다. 그리고 대부분의 DBMS에서 이를 지원한다... 다만 MySQL/PostgreSQL의 경우 튀어나온 relation에 반드시 이름을 붙이도록 하고 있으며, Oracle의 경우는 속성에 대해서 이름을 변경하는 것을 허용하지 아니한다.
더불어, from절에서의 nested subqueries의 경우 같은 form절의 다른 relation에 대해서 correlation을 사용하지 못하는데 (걍 from절의 다른 얘 못가져 옴), lateral keyword를 붙이게 되면 이를 허용해 준다. 예를 들어서 아래와 같은 SQL문이 있겠다.
select name, salary, avg_salary
from instructor I1, lateral (select avg(salary) as avg_salary
from instructor I2 where I2.dept_name = I1.dept_name);
The with clause
with절이라는게 튀어나오는데, "한 쿼리"에서만 임시로 사용되는 Relation을 소환할 수 있게 해주는 친구라고 생각하면 된다. 이해가 안된다면 아래와 같은 SQL문을 한번 읽어보자.
with dept_total(dept_name, value) as (
	select dept_name, sum(salary) from instructor group by dept_name),
    dept_total_avg(value) as (
    select avg(value) from dept_total)
select dept_name
from dept_total, dept_total_avg
where dept_total.value > dept_total_avg.value;
Modification of the Database
그리고 이제 짜잘짜잘한(?) Delete, Insert, Update에 대해서 알아보자.
delete from instructor
where salary between 13000 and 15000;
delete~ 의 경우 그냥 말그대로 해당하는 튜플들을 전부 숙청시켜 버린다.
insert into course (course_id, title, dept_name, credits)
	values ('CS437', 'Database', 'Comp. Sci', 3);
insert 절의 경우 한 튜플을 집어넣는 절이라고 볼 수 있다. 참고로 엥간한 DBMS에서는 한개씩이 아니라 벌크로 데이터를 집어넣는 절을 지원함으로 그를 적절하게 이용하도록 하자. (참고로 뒤에 values 때고 서브쿼리 집어넣기 가능)
update instructor
set salary = salary * 1.05
where salary < 70000;
update ~ set ~ 절의 경우 말그대로 데이터를 수정한다. 근데 문제는 뭐냐면, 업데이트를 쪼개서 수행하게 되면 꼬이는 경우가 발생한다는 거다. 예를 들어서, 봉급이 10만 넘어가는 얘들은 3프로 올려주고 "아니면" 5프로 올려준다 해보자. 이걸 각각 쪼개면 경우에 따라서 1.03 * 1.05가 되는 경우가 발생한다.( 예 : 99,000 - > 103,950(*1.05, 쨋든 10만은 아니므로) -> 107,068(10만이 넘어감으로))
그래서 case 구조를 SQL에서는 제공한다. 얘는 여러 수정에 대한 케이스를 한 update에서 해주게 만들어준다. 예를 들어서, 아래와 같은 SQL문이 있겠다.
update instructor
set salary = case
	when salary <= 100000 then salary * 1.05
    else salary * 1.03
    end
Ref : Database System Concepts, Seventh Edition (Abraham Silberschatz etc.)
'Computer Science > DataBase' 카테고리의 다른 글
| Relational Algebra (0) | 2026.10.22 |
|---|---|
| Introduction to DB... (0) | 2026.10.21 |