
2026. 10. 21. 18:30ㆍComputer Science/DataBase
데이터베이스 시스템은 큰 용량의 정보를 안전하게 담는데 있어서 적합하게 설계되어 있고, 이러한 데이터베이스를 관리해 주는 프로그램을 Database-management System(DBMS)라고 한다. 대표적인 DB로는 Oracle, MySQL, Porstge, Mongo등이 있겠다. 참고로 Supabase나 Firebase는 BaaS의 축에 들어감으로 DB라 하기에는 조금 거시기한 감이 있다. 쨋든 데이터베이스 시스템은 고가치/고용량/다수에 의해 접근 가능한 정보들을 저장 및 관리하는데 사용된다. 대게는 (상대적으로 작은 데이터를 불러오고 업데이트 하는) 온라인 처리를 하거나, 데이터 분석에 있어서 사용된다.
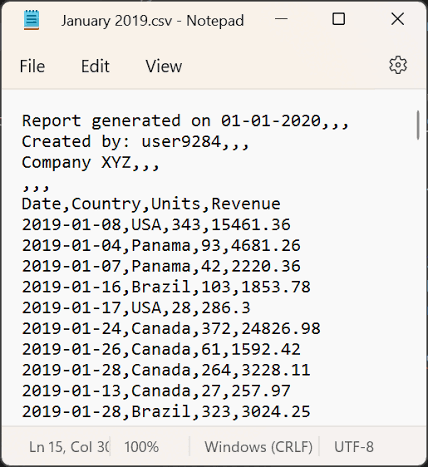
여기서 문득 드는 생각. 그냥 데이터를 JSON이나 CSV같은 파일에 때려박으면 안되는 것인가? 물론 야매로 게임을 개발한다거나, 아니면 바이브 코딩을 해서 대충 실현만 할 생각이라면 그래도 된다. 하지만 이러한 파일을 이용한 처리에는 단점이 있으니....
- 데이터 중복과 비일관성 (Data Redundancy and Inconsistency)
: (ChatGPT가 나오기 이전의) 프로그래머들은 기기 괴괴한 머리 싸움을 했기 때문에, 파일 구조가 프로그램마다 다르다거나 프로그래밍 언어가 다르다거나 한건 당연한 일이다. 더불어 "기술적 및 편의상"의 이유로 같은 정보가 여러 군데에 드래곤볼 해놓는건 아주 흔한 일임으로 (필자도 매우 즐겨함) 어디의 개복치는 눈이 1개인데 어디의 개복치는 눈이 32486개인 일이 비일비재 할 수 밖에 없다. DB를 안쓴다면! - 데이터 접근의 어려움
: DB는 SQL로 깔딱 해서 원하는 데이터를 바로 불러올 수 있지만, 파일로 관리한다면 원하는 정보를 불러오기 위해서 프로그래밍 언어로 거기에 맞는 로직을 짜야하니 이 얼마나 끔찍한 일인가? - 데이터의 분리
: 1번에서 서술했다 싶이, 데이터가 드래곤볼 마냥 군데군데 흩뿌려지면.. 원하는 데이터를 불러오기 어려워진다. - 그 외에도 파일의 Atomicity 문제라던가, 동시 접근 처리의 문제라던가, 보안 문제라던가....
그래서 DB가 나왔다!
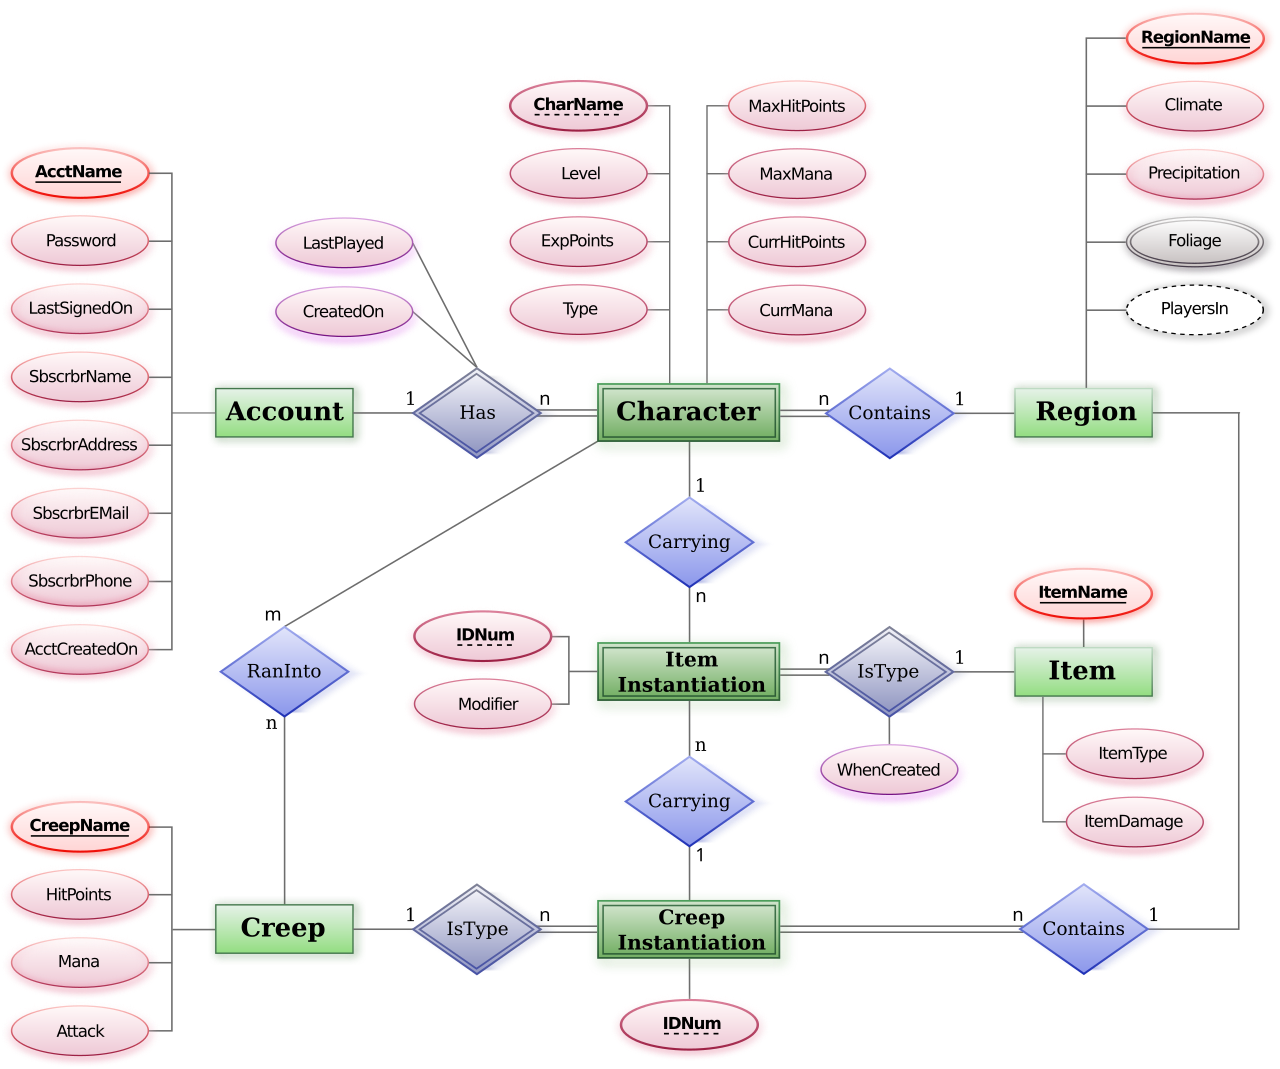
다만 Database는 data model이라는 구조 하에서 돌아가게 된다. 이건 대충 데이터 구조/semantics/consistencty를 설명하는 거시기라고 생각하면 편할 것이다. 사실 data model의 종류를 따지자면 되게 많은데, 대충 아래와 같은 것들을 생각해 볼 수 있을 것이다.
- Relational Model : 대충 엑셀에서 볼 수 있는 그거 맞다. (여러개의 열, 각 열은 unique name)
- Entity-Relationship Model : 데이터를 객체와 그 사이의 관계들로 표현한다.
- Semi-structured Data Model
- Object-Based Data Model
또한 "상식적으로" 모든 "정보"를 떼려박을수는 없는 관계로, 데이터에 대해 추상화를 진행해서 효과적으로 저장하려 할 것이다. 이는 Physical/Logical/View Level로 나눌 수 있겠다. 예를 들어 학번이 다른것은 Physical level이고, 학생 DB의 학번이 Primary Key인 것은 Logical View일 테고, 교무처에서 특정 학생의 정보만을 볼 수 있는 것은 View Level에서의 이야기일테다.
쨋든 DB란 이런 것이다! 이제 다음부터는 머리아픈 이야기를 해보도록 하자.
Reference : Database System Concepts, Seventh Edition (Abraham silberschatz and etc.)