
2026. 11. 19. 19:22ㆍComputer Science/Operating System
앞에서 본 프로세스 스케쥴링 알고리즘의 최악의 문제점은, 코어가 하나일때를 가정했다는 점이다. 만약 CPU에 코어가 여러개 박혀있는 경우이고(혹은 CPU가 여러개 박혀 있다거나), 여러개의 스레드가 병렬적으로 돌아가게 된다면... Load Shariing을 비롯해서 좀 복잡한 문제점이 생길 것이다. 그러니 방법론을 한번 같이 알아보도록 하자.
Approaches to Multiple-Processor Scheduling (CPU가 2개 이상)
일단 생각해 볼 수 있는 건.. 스케쥴링 디시전이던, I/O던, 아니면 다른 시스템 활동이던간에 하나의 프로세스를 마스터 서버로 두고 걔한테 떠넘겨버리는거다. 이러한 asyymmetric multiprocessing은 참으로 간단하다면 간단하다고 할 수는 있는데... Master Process에 Overload가 걸릴것이 자명하다.
따라서 현대적인 표준 접근법은 SMP(Symmetric multiprocessing)을 사용한다. SMP의 골자는 각각의 프로세서가 알잘딱 하게 스케쥴링 하자는 것으로.. 이는 각각의 프로세서가 스케쥴러를 가지게 함으로서 언제 레디큐에 기어 들어가고 실행될지를 정하자는 것이다. 그리고 이런 경우에는 뭐가 스케쥴 될지 크게 두가지 전략을 세울 수 있는데....
- 모든 스레드가 흔한 ready queue에 있게 하기
- 각각의 프로세서가 스레드들에 대해서 고유의 레디큐를 가지고 있게 하기
전자의 경우 Race Condition의 가능성이 존재하는 관계로, 후자의 전략을 일반적으로는 채택하게 된다. 그리고 후자의 전략이 캐시 메모리를 좀 더 효율적으로 쓸 수 있기도 해서..
Multicore Processors
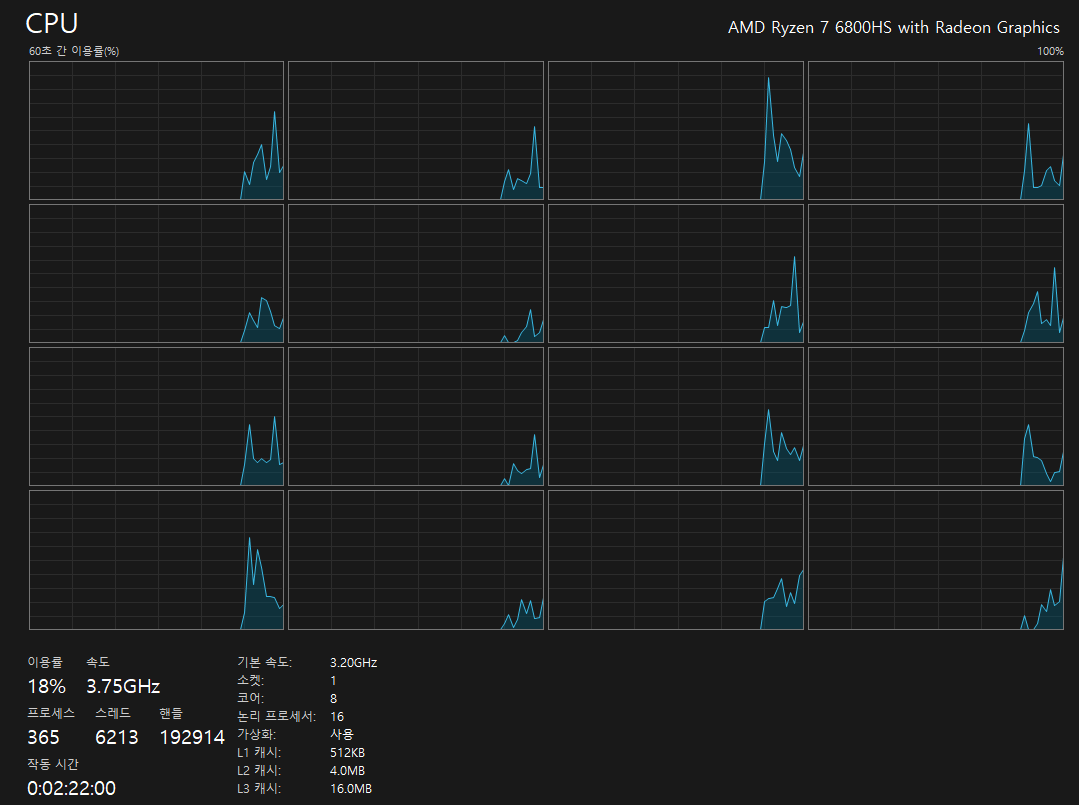
관행적으로 SMP는 여러개의 프로세가 병렬적으로 돌아갈 수 있게 해줬다. 근데 이제는 1CPU 다코어의 시대가 도래하지 않았는가. 그리하여 Multicore Processor가 등장하게 되었다. 그리고 SMP도 여기에 당연하게 적용할 수 있다.
다만 여기에 Chip Multithreading(or Hyper-Threading/SMT) 을 도입해서 하나의 코어에 여러개의 하드웨어 스레드를 쳐 박는다. 대표적으로 인텔의 경우 하이퍼스레딩이라는 이름으로, 물리적으로 코어가 4개여도 논리적으로 8개가 보이게 해준다. 이러면 memory stall에 참 잘 대응해서 성능이 올라가는 효과가 있다. (말해서 한 CPU 사이클 안에서도 여러 스레드의 명령어를 함께 발행해 줄 수 있게 되는 셈. 이는 CPU 내부에 ALU같은게 여러개 있어서 가능한 일이다. 즉 코어 내부에서 남아도는 유휴 자원을 SMT 형태로 사용할 수 있게 해준다.)
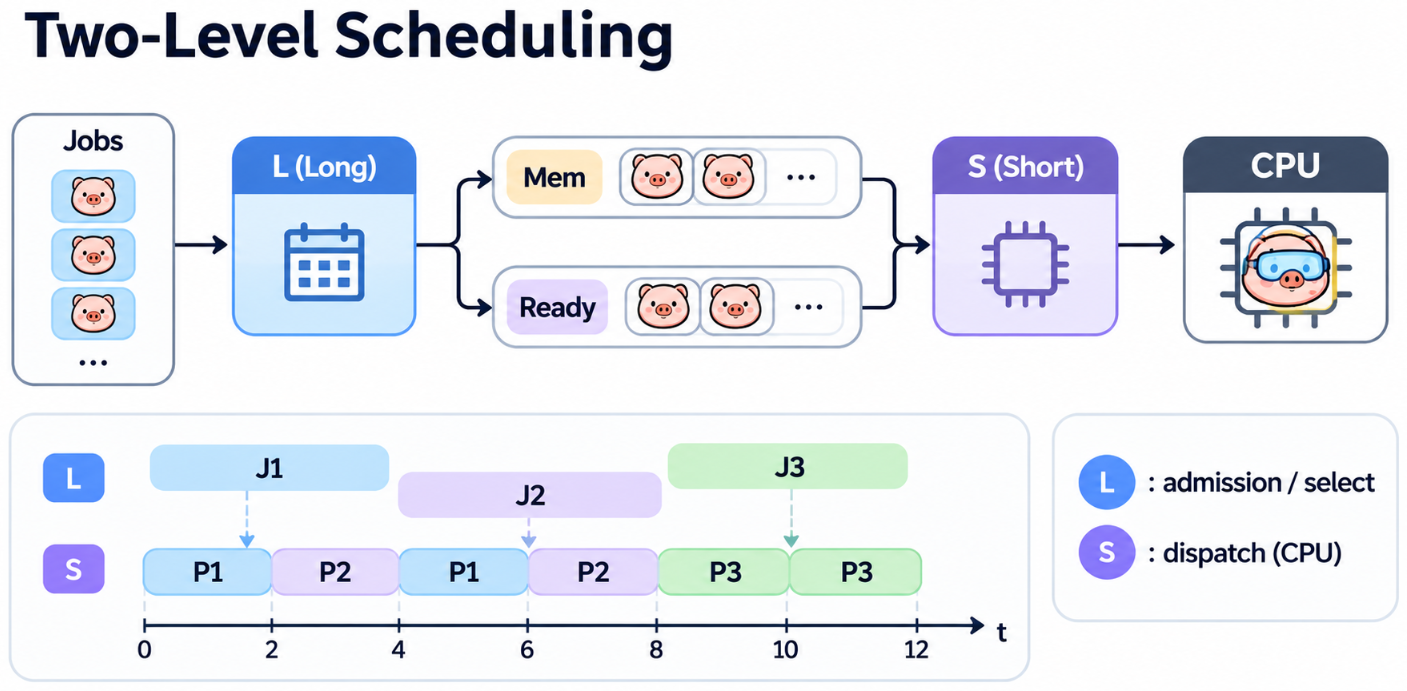
그리고 이러한 멀티코어 체제에서 스레드를 전환할 일이 꼭 있는데.. 이때는 coarse-grained/fine-graine multithreading 방법이 존재한다. 전자의 경우, 만약 레이턴시가 늘어지는 작업이 있으면 다른 스레드로 갈아끼워 버린다. 그리고 교체 비용이 상당히 크게 된다(파이프라인에서 스레드가 가지고 있던 정보를 치워야 함으로.) 반면 후자의 경우, 시간을 잘라서 매번 교체하게 된다. 구조상 이렇게 하기 때문에, 교체 비용은 상대적으로 작게 된다. 결과적으로는 아래와 같이 표현할 수 있게 된다.
소프트웨어로 생성되는 스레드(Software Thread)와 하드웨어에서 돌아가는 스레드(Hardware Thread)는 차이가 있음을 유념하자. 예를 들어서 Logical한 친구들은 32486개가 있을 수 있지만 CPU가 실제로 한번에 돌릴 수 있는건 끽해야 코어수 * 2다. (SMT가 코어수 * n도 되지만 그 이상으로 가면 딱히 효율이...)
Load Balancing
쨋든 (프로세서가 각각의 고유한 레디큐를 가진) SMP 시스템에서는, 프로세서(던 간에 코어던)간에 Load에 대한 균형을 맞추는게 중요하다는 점을 쉽게 유추할 수 있다. 만약 균형이 맞지 않는 다면, 다른 스레드는 열심히 갈궈지는 동안 어떤 얘는 놀고 있는 사태가 발생할 수 있는것 아니겠는가? 실례로 인텔이 P-코어와 e-코어를 도입할때 이 둘을 구분해서 배정하느라 MS에서 고생을 좀 했다.
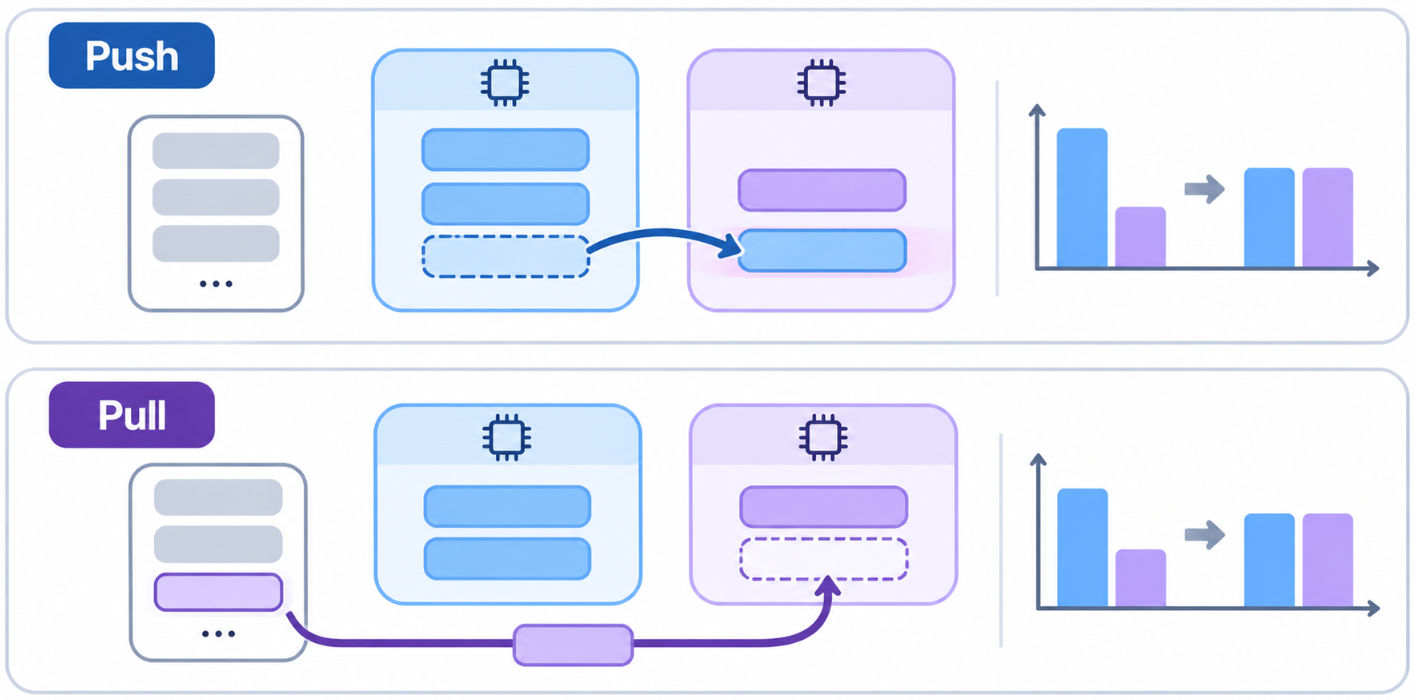
이때 로드 벨런싱에는 크게 두가지 방법이 있다. 첫번째는 push migration으로, OS가 관찰하다가 만약 리소스의 불균형이 관찰된다면 - 해당 (Logical) 스레드를 다른 프로세서로 유배보내는 것이다. 두번째로는 Pull Migration으로, 놀고 있는 스레드가 작업할 리소스를 땡겨 오는 것이다. 이때 이 둘은 서로 상호 베제적이지 않으며, 실제로 둘 다 다양하게 쓰인다.
Processor Affinity
위에서는 스래드 단위로 얘기를 자주 했는데, 캐시 메모리에 뭔일이 생기는 지도 관찰할 필요가 좀 있다. 캐시야 말로 컴터 성능에 지대한 영향을 미치기 때문. 근데 문제는 위에서 Load Balancing 한답시고 스레드를 옮겨 댔는데, 그렇다고 해서 캐시 메모리에 있는 내용이 같이 따라가지는 않을 것 아니니 여기에 대한 작업을 해줘야 될것 아닌가?
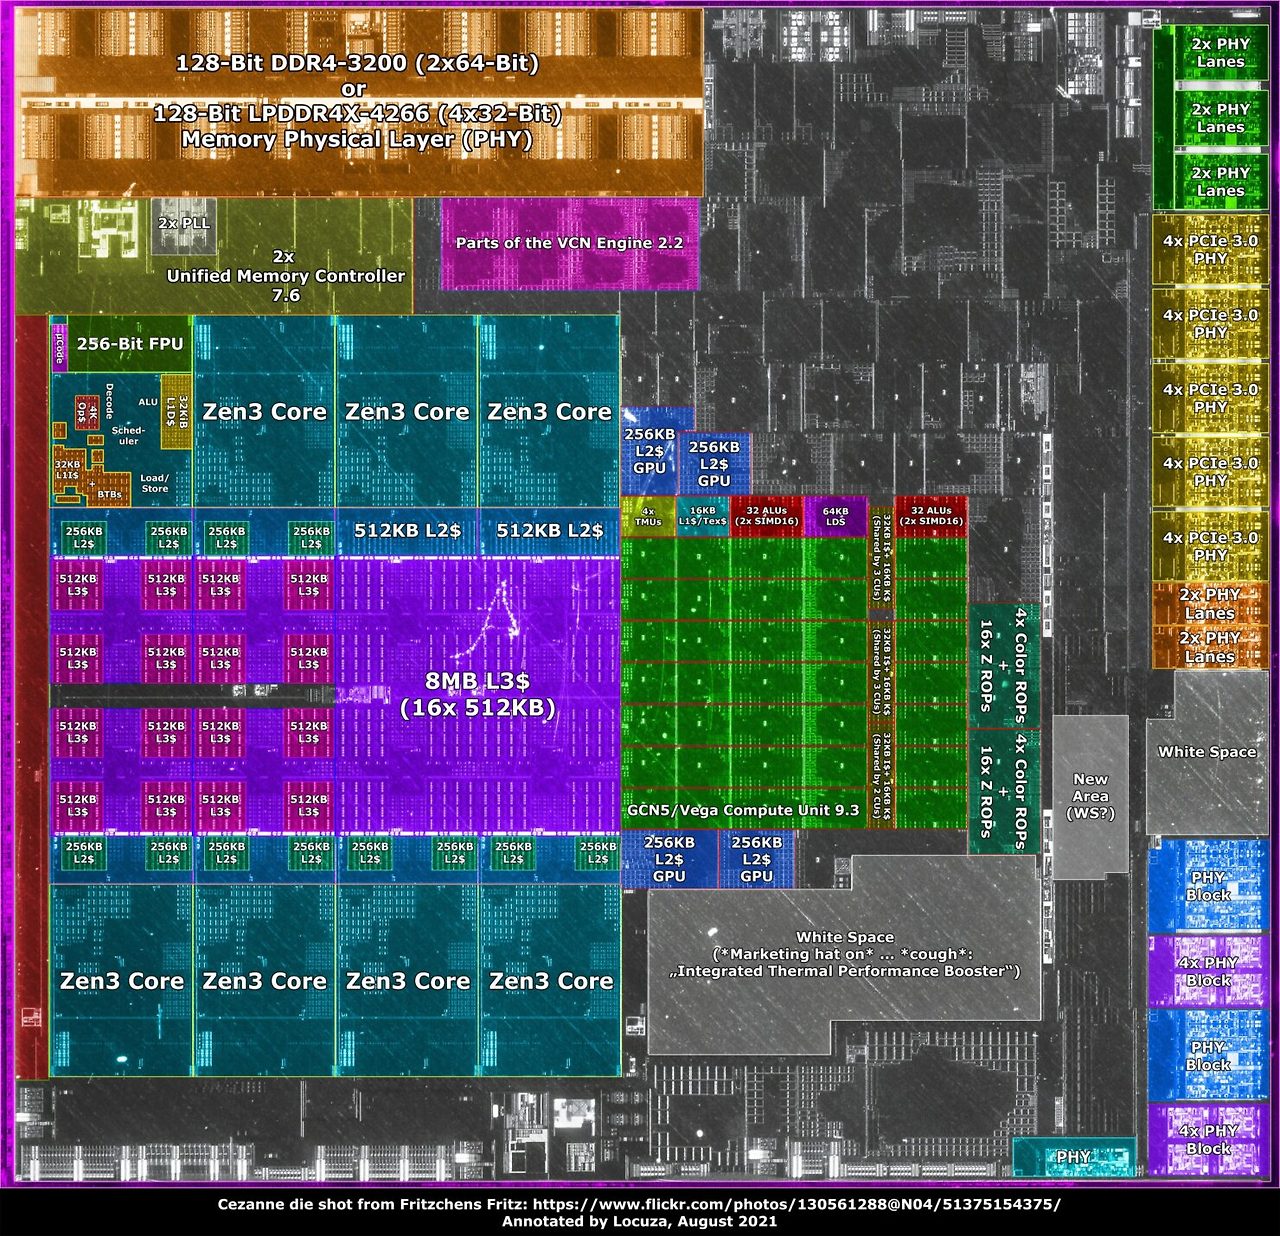
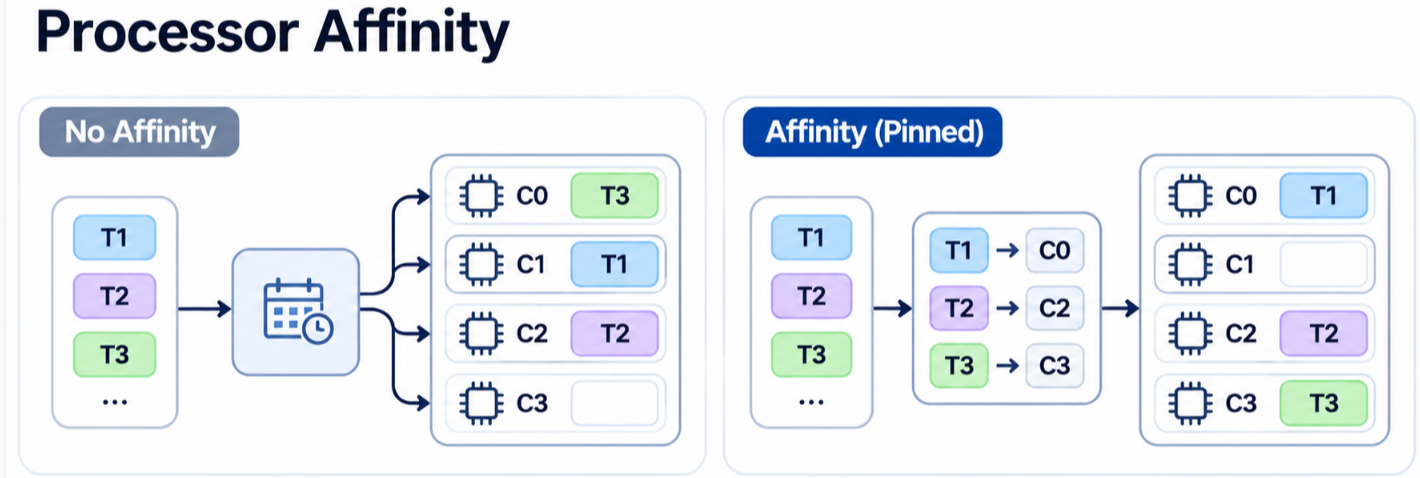
다행이도 한 CPU 안에서 (L1/L2 캐시가 아닌 한) 캐시는 공유되는 편임으로, 대부분의 SMP를 지원하는 OS의 경우는 스레드를 유배보낼 때 한 프로세서 안에서만 하는 편이다. 이를 processor affinit(프로세서 선호도)이라고 하게 된다. 이때 OS가 프로세서 단위로 왔다리 갔다리 하지 않게 "노력하려 한다면" Soft affinit이라고 하게 되고, 반면에 이를 "반드시 지킬것 이라면" hard affinit이라고 하게 된다. (대부분의 OS에서는 둘다 지원하는 편.)
Heterogeneous Multiprocessing (이기종 멀티프로세싱)
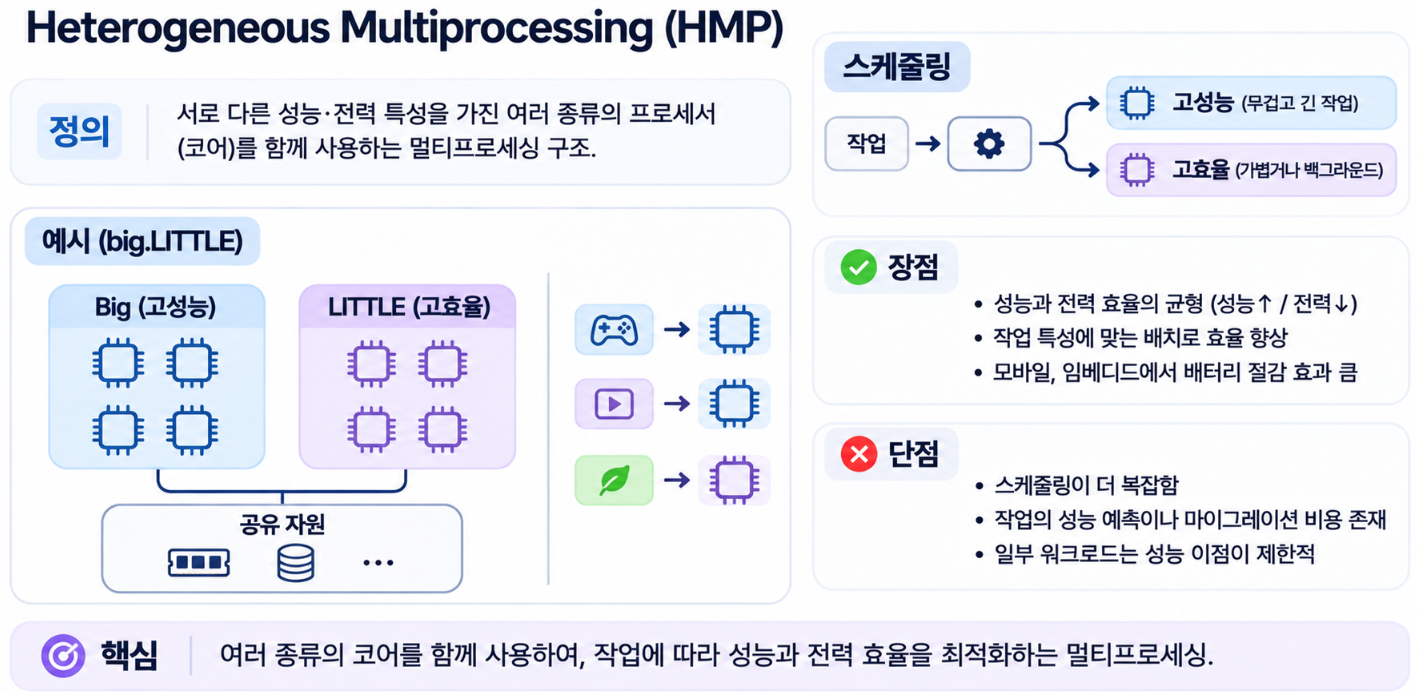
앞에서 인텔 얘기한 것과 같은 얘기이다. 단지 차이점이라면 모바일 CPU (예 : 엑시노스, ARM)의 경우 좀 선진적으로 Big-Little 구조를 도입했고, 데스크탑의 경우 좀 늦었다는것. 어찌 되었던 HMP는 각각 성능이 다른 코어를 한 칩에 다 때려박고 공유 자원을 사용하게 하는것을 의미한다.
이렇게 함으로서 Load가 낮은 작업은 Little코어에 때려박고, Load가 큰 작업은 Big코어에 떼려 박아 전력 효율성을 높일 수 있게 되었다. 다만 문제는 스케쥴링이 상당히 머리아파지게 됨으로 (앞에서 서술한 인텔과 같은) 여러 해결해야 될 사항이 발생한다. 그러므로 만약 본인이 인텔 12세대 이상 CPU를 쓴다면 Windows 11을 설치하는 것을 권장한다.
Ref : Operating System Concepts, 10th edition.
'Computer Science > Operating System' 카테고리의 다른 글
| CPU Scheduling Algorithms (0) | 2026.11.18 |
|---|---|
| Thread Strategy (0) | 2026.11.18 |
| About Process (2) : Process Scheduling (0) | 2026.11.12 |
| About Process (1) : Memory, and State (0) | 2026.11.12 |
| System Calls (0) | 2026.11.04 |