Sorting in Linear Time
Merge/Heap/Quick Sort같이 Comparsion을 이용한 Sorting의 경우 최저 하한선이 O(NLogN)가 된다. (Decision Tree를 통해 시각화 하면 -> n개 element에 대해서 Decision Tree의 Height 만큼인 LogN번 Comparision 해야 되기 때문.)
하지만 Counting/radix/bucket Sort의 경우 저러한 하한선을 깨고 (경우에 따라서) O(N) 안에 정렬을 마무리 할 수 있다! 이는 정수의 범위 제한/분포 같은 추가 정보를 이용한 것이다.
Counting Sort
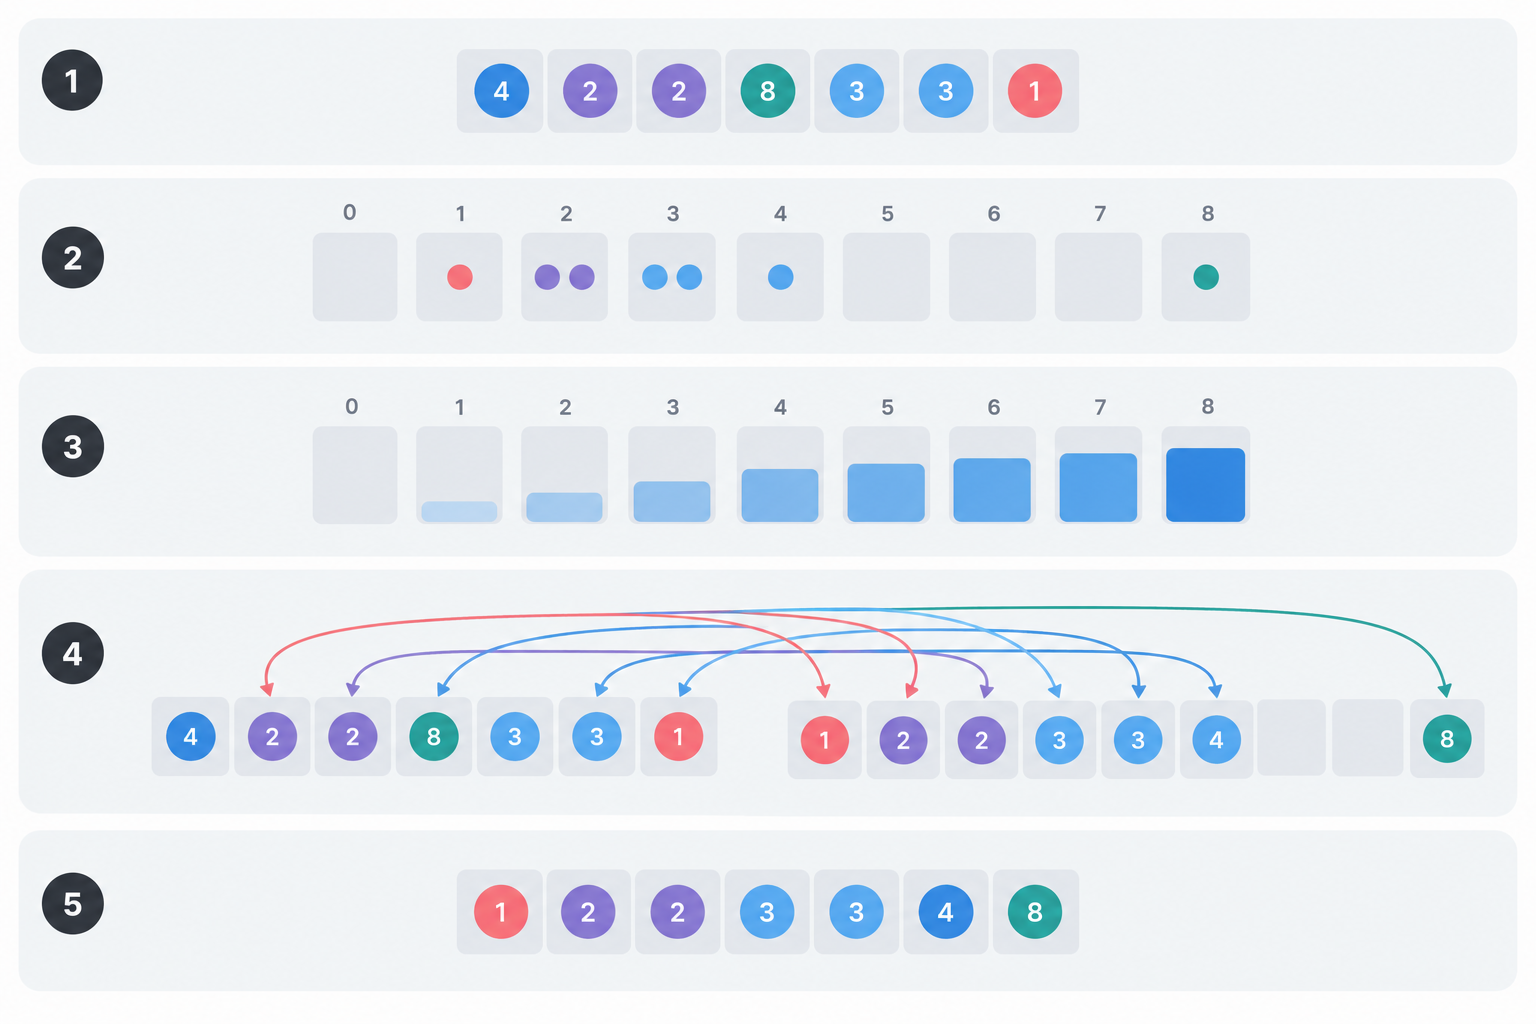
Counting Sort는 n개의 요소들이 0 to k의 정수라고 가정할 때 작동한다. 그럼 한번씩 순회하면서 0 to k의 element가 각각 몇개인지 세고, 그 정보를 바탕으로 output을 만들면 O(N) 내에서 시마이를 칠 수 있지 않겠는가? 물론 for loop를 여러번 돌리긴 하겠다만, 결국엔 O(2N) = O(32486N) = O(N)으로 계산 할 수 있으므로...
그리고 누적합을 이용하게 된다면, stable 하게 같은 키를 가진 요소들의 순서를 복원해 낼 수 있다.
Radix Sort
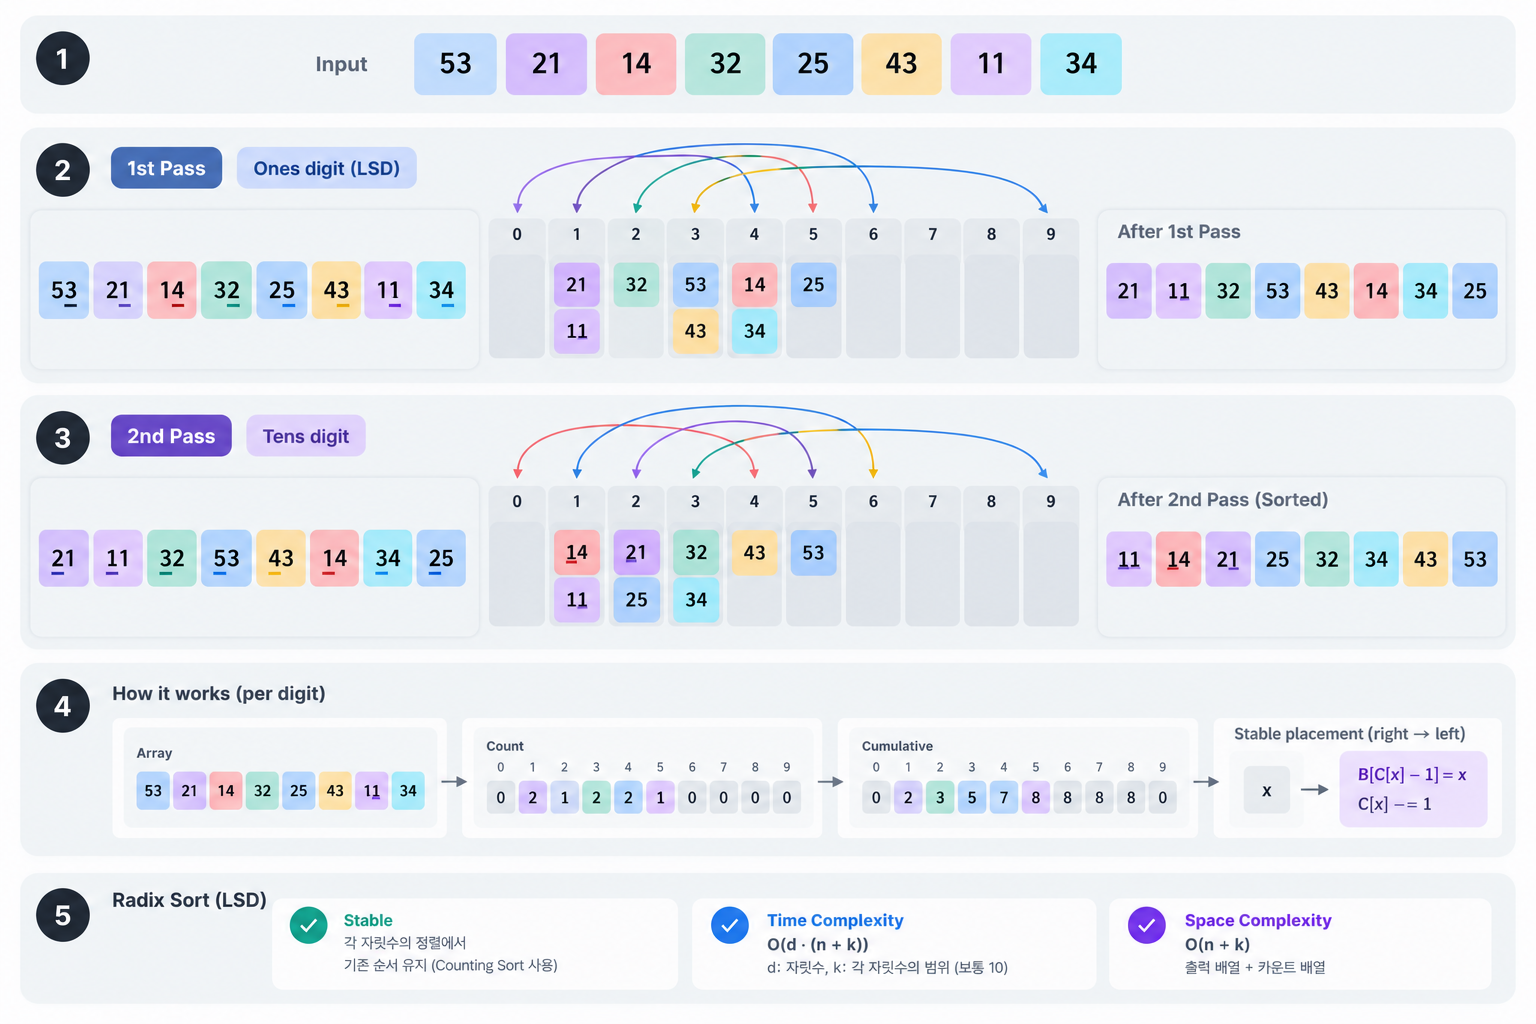
LSD(Less Significant Digit) Radix Sort에 대해서 먼저 이야기 하고 가자. 얘는 일단 일에 자릿수에 대해서 정렬을 때리고, 10에 자릿수에 대해서 정렬을 때리고, 100의 자릿수에 대해서 정렬을 때리고... 하는 식으로 정렬을 해내는 알고리즘이라고 할 수 있겠다. 물론 자릿수가 크면 안드로메다로 가긴 하겠는데, 뭐 어쨋든 선형 정렬이긴 하다. 그리고 이와는 반대로, 가장 큰 자릿수 먼저 정렬을 때리는 알고리즘을 MSD(Most Significant Digit) Radix Sort라고 한다.
그리고 각 자리수를 key로 잡아서 비교하는 과정에 위에서 언급한 Counting Sort가 활용되게 된다. Radix Sort 과정에서 각 자리수를 key로 잡아서 비교해야 하기 때문. 물론 여기에 Comparison을 가져다 쓸 수 있을수도 있겠다만 굳이 그런짓을?
Bucket Sort
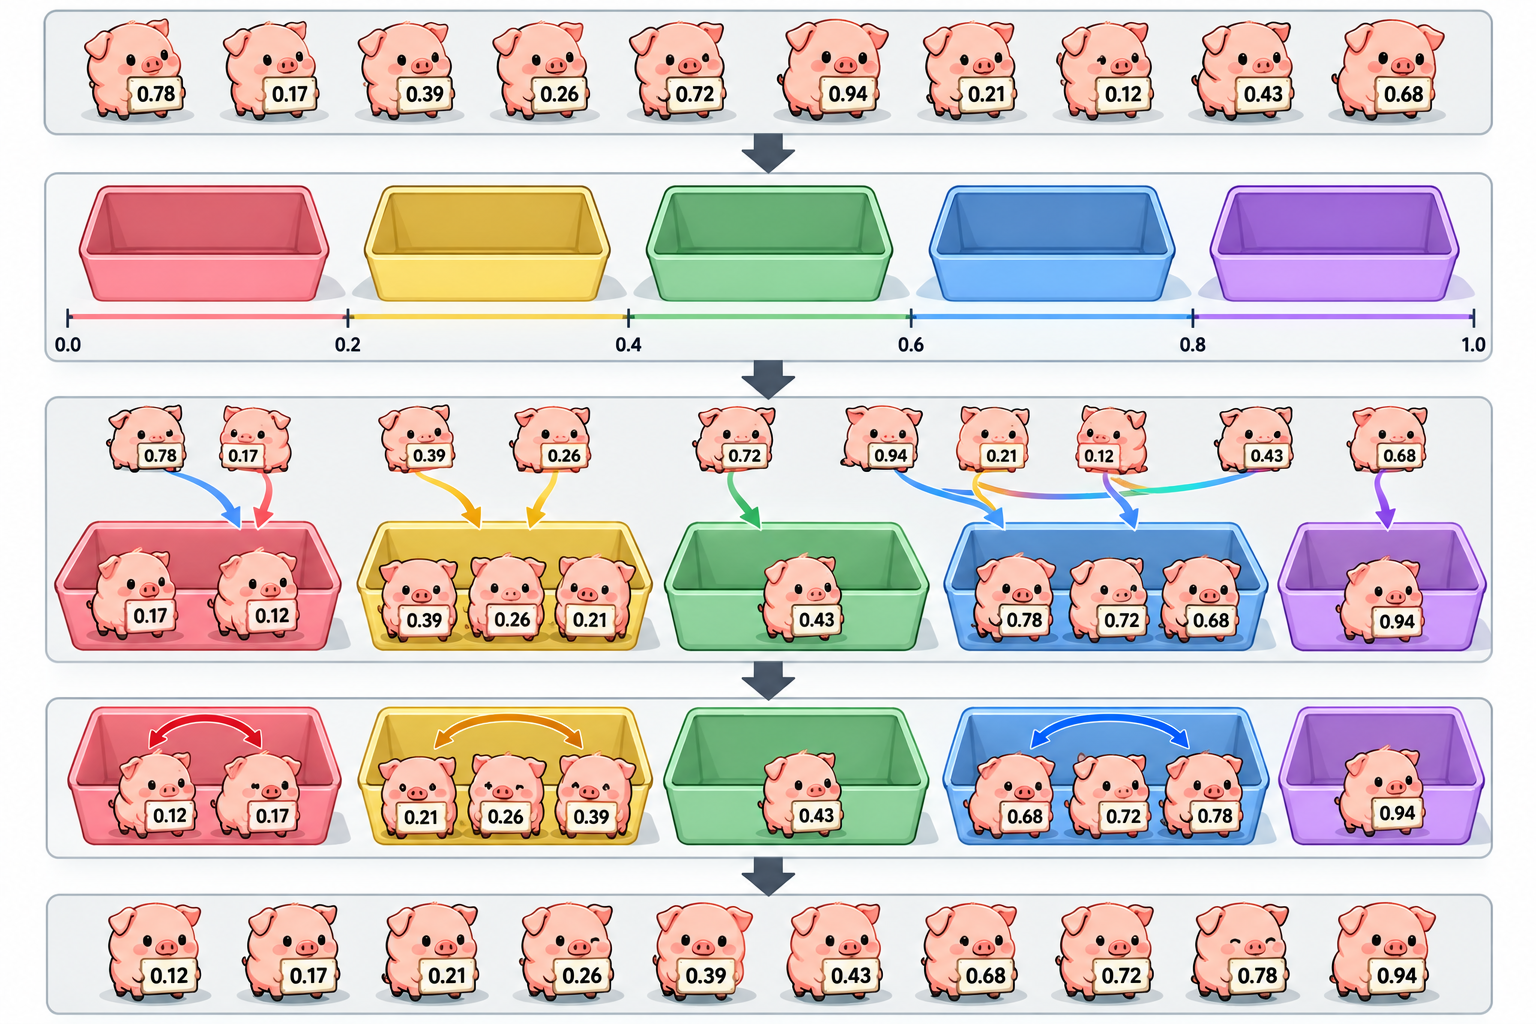
Bucket Sort는 각각의 요소들이 균등한 분포를 가지고 있다고 하면 평균적으로 O(N)의 시간복잡도에 수렴하게 된다. 왜냐하면 Bucket Sort가 쓰는 아이디어가 구간별로 나눈 버켓에 요소들을 때려 박고 각 요소들에 대해서 Sort하겠다는 소리이기 때문이다. 참고로 이는 위의 Counting Sort의 아이디어와 상당히 유사하다고 할 수 있을 것이다.
근데 요소가 불균등 해서 어느 List에 싹다 몰리면 최악의 경우에는 O(N^2)에 수렴할 것 아니겠는가? 그래서 균등한 분포에 대해서 돌리면 참 좋은 Sort라고 할 수 있을 것이다. 참고로 Bucket 내부에서는 Linked List를 사용한다. (나중에 정렬된 얘들 가져다가 이어 붙이면 그만임으로.)
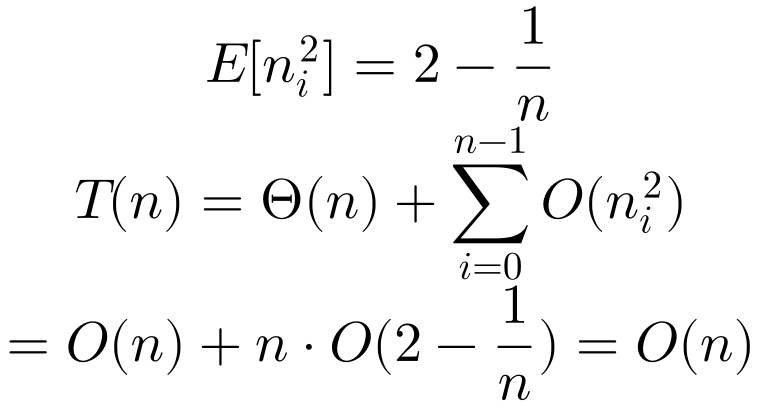
Ref : Introduction to Algorithms, Cormen, 3rd edition.